CitySpark · 城事雷达
把同城的小众活动,推给正好会去的人

想解决的问题
城市里的展览、手作、脱口秀、市集、沙龙、戏剧,大多没有像样的分发渠道。要推得准,得同时满足五个条件:同城、没去过、还能报名、时间不冲突、合口味。任何一个不满足,推荐就是无效的。
CitySpark 把这件事拆成一条完整的推荐链路,并且把「凭什么推这个」也一起交出来。
六路召回,各自都能跑
| 路径 | 实现 | 缺可选依赖时 |
|---|---|---|
| UserCF | 加权 Pearson / Cosine / Jaccard 混合相似度 + 共同数收缩 | 无需可选依赖 |
| ItemCF | 活动向量余弦、热门校正、Top-K 相邻活动 | 无需可选依赖 |
| MF | implicit 的 BPR |
降级为 sklearn TruncatedSVD |
| 图传播 | 归一化二部图上的个性化重启传播 | 始终可用(未声称实现可训练 LightGCN) |
| 语义 | 标题 + 描述 + 标签 + 规则/LLM 画像;TF-IDF 或句向量 | 降级为 TF-IDF + NumPy 余弦 |
| 热门探索 | 同城对数热门度 + 新活动指数衰减 | 无需可选依赖 |
隐式反馈按 view=1 / favorite=3 / share=4 / signup=5 加权,每条事件再乘时间衰减(半衰期 30 天),同时给每个活动加 1/log(1+活跃用户数) 的热门惩罚——否则热门活动会把长尾全吃掉。
过滤是这道题的一半
推荐系统最容易翻车的地方不是排序,是「推了个你已经报过名的活动」。这里做七类过滤:已收藏、已报名、标记不感兴趣、异地、下架或售罄、已经开始、与历史报名时段冲突,再加距离阈值和重复事件去重(同 event_group 只留一条)。
余量按截点前的不重复报名数算,距离用模拟经纬度的 Haversine。
实验是怎么做的
没有随机拆行。 按时间切分,最后一周永远留作测试:
| 阶段 | 可见历史 | 标签窗口 |
|---|---|---|
| 排序训练 | 10-08 之前 | [10-08, 10-15) |
| 测试 | 10-15 之前(召回重训,排序器冻结) | [10-15, 10-22) |
数据是 160 用户、240 活动、11,438 条行为、860 条评分的模拟集(seed 42),测试截点前特意注入了零历史的新用户和新活动,冷启动不是事后补的。
结果
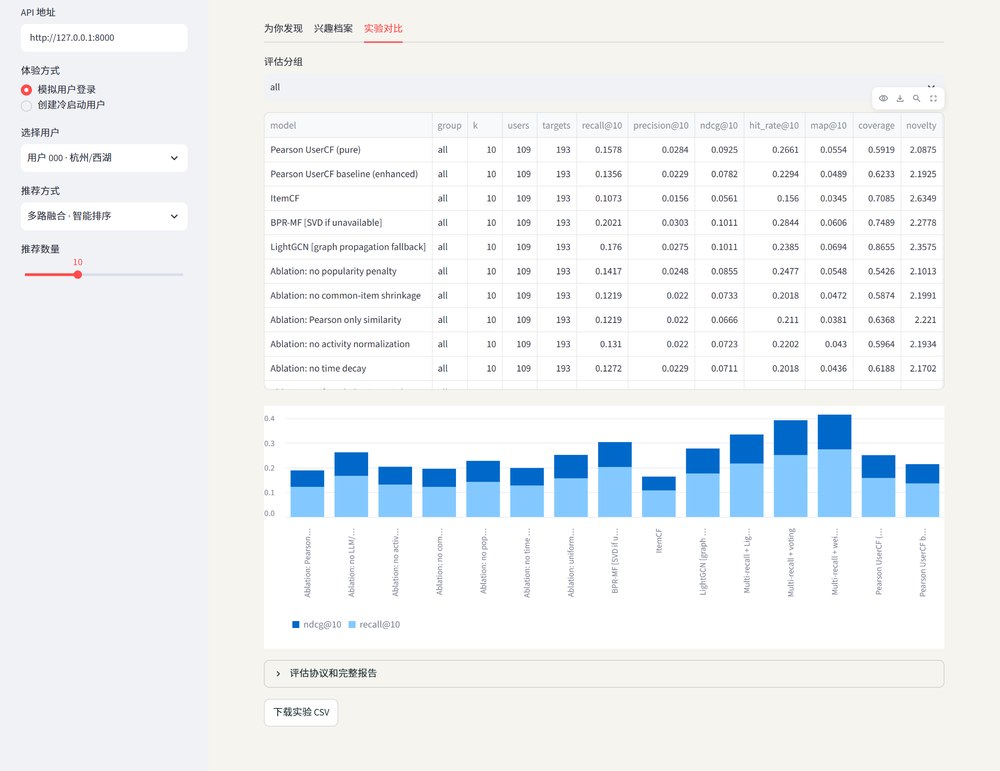
K=10,109 个有可推荐正例的用户,193 个目标:
| 方案 | Recall@10 | NDCG@10 | 覆盖率 | 新颖度 |
|---|---|---|---|---|
| 纯 Pearson UserCF | 0.1578 | 0.0925 | 0.5919 | 2.0875 |
| 增强 UserCF baseline | 0.1356 | 0.0782 | 0.6233 | 2.1925 |
| ItemCF | 0.1073 | 0.0561 | 0.7085 | 2.6349 |
| BPR-MF | 0.2021 | 0.1011 | 0.7489 | 2.2778 |
| 多路融合 · 加权 | 0.2739 | 0.1407 | 0.8161 | 2.6639 |
| 多路融合 · 投票(RRF) | 0.2506 | 0.1411 | 0.7130 | 2.5398 |
| 多路融合 · LightGBM | 0.2162 | 0.1178 | 0.8610 | 3.4280 |
三件我原本预期相反的事,报告里都按实测写了:
- 加权融合的 Recall@10 高于 LambdaRank。 学过排序不一定赢过调好的权重,至少在 109 个用户的样本量上如此。
- 增强版 UserCF 没有全面优于纯 Pearson。 加了热门惩罚、共同数收缩和相似度混合之后,Recall 反而从 0.1578 掉到 0.1356——这道题上它没赚回来。
- 六路召回的候选上限是 0.9145,实际最好的方案只有 0.2739。 瓶颈不在召回,在排序和过滤。
冷启动
17 个冷用户在纯协同过滤下 Recall 全为 0(这是必然的,没有历史就没有邻居)。多路融合把冷用户 Recall 拉到 0.1961(加权)和 0.2745(LightGBM)——靠的是语义画像和热门探索这两条不依赖历史的路。
冷活动(29 个)相反:加权融合仍然拿不到正例,LightGBM 能到 0.2414,靠的是特征里有新旧程度和标签匹配。
可解释
LambdaRank 的每种召回路径返回一个 TreeSHAP 贡献组(含 context 和 bias),各贡献之和等于原始排序分数;界面里能直接展开看每路给了多少分,同时附上原始召回证据。排序分数不是概率,负贡献也是正常的——界面里写明了这一点,不把分数包装成置信度。
当前边界
- 全部是模拟数据,单个合成时间窗。「离线指标高」不等于「线上就好」,真实系统需要多窗口验证和线上 A/B。
- 协同相似度在演示规模上用稠密矩阵计算,百万级用户/活动必须换稀疏 Top-K、ANN 和增量训练。
- 活动价格、区域目前是排序信号和解释维度,不是被学出来的因果因素。
- 没有生产鉴权、多租户隔离或分布式库存事务,API 默认绑定回环地址。前端是 Streamlit,属于演示界面而言而非产品级前端。
项目图集