陆运智报价
在对话里把一句运输需求,变成一张说得清来历的报价单
一个真实的摩擦点
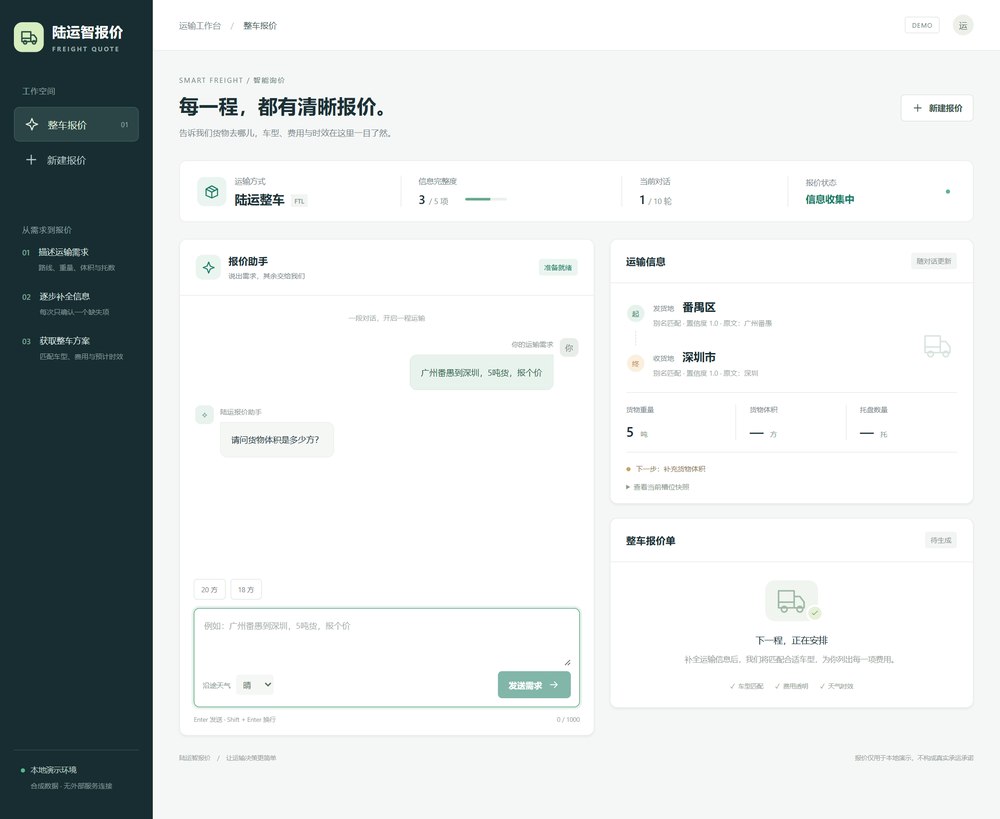
整车运输询价,客户开口往往是不完整的:「广州番禺到深圳,5 吨货,报个价」。
这句话缺体积、缺托数,而这两项决定了车型能不能装下、要不要计抛。传统做法是人工来回问三四轮,或者让客户填一张表单。这个 demo 把这段来回交给状态机:缺什么问什么,一次只问一项。
状态机而不是表单
用 LangGraph 搭的显式状态机,条件路由只有两条岔路:还有缺项就去追问,齐了就去算价。有两个设计我认为比技术选型更重要:
slots 是唯一业务事实源,messages 只保留最近 5 轮。 对话历史只用于理解这一轮的意图,报价判断只读槽位。这样用户中途改了发货地,槽位被覆盖,历史里的旧说法不会污染结果。
第 10 轮优先熔断,即使当轮信息已经完整。 这是反直觉的一条:补全了就报价不行吗?不行——对话拖到 10 轮说明 AI 没听懂或用户在绕圈,继续下去只会更糟。熔断后把这一轮的负样本写进 negative_samples.jsonl,留给后续优化。
地址解析:三级降级,每一级都说得出来
用户写的地名不会规整。这里做了三级:
| 级别 | 做法 | 例子 |
|---|---|---|
| L1 | 别名精确匹配 | 「羊城」→ 广州 |
| L2 | 去掉行政后缀,比较无声调拼音,编辑距离 ≤2 且唯一最优才接受 | 「番禹」→ 番禺区 |
| L3 | 仅对已知城市和带行政后缀的中文地名做模拟判定 | 明显未知地址返回 none,不瞎猜 |
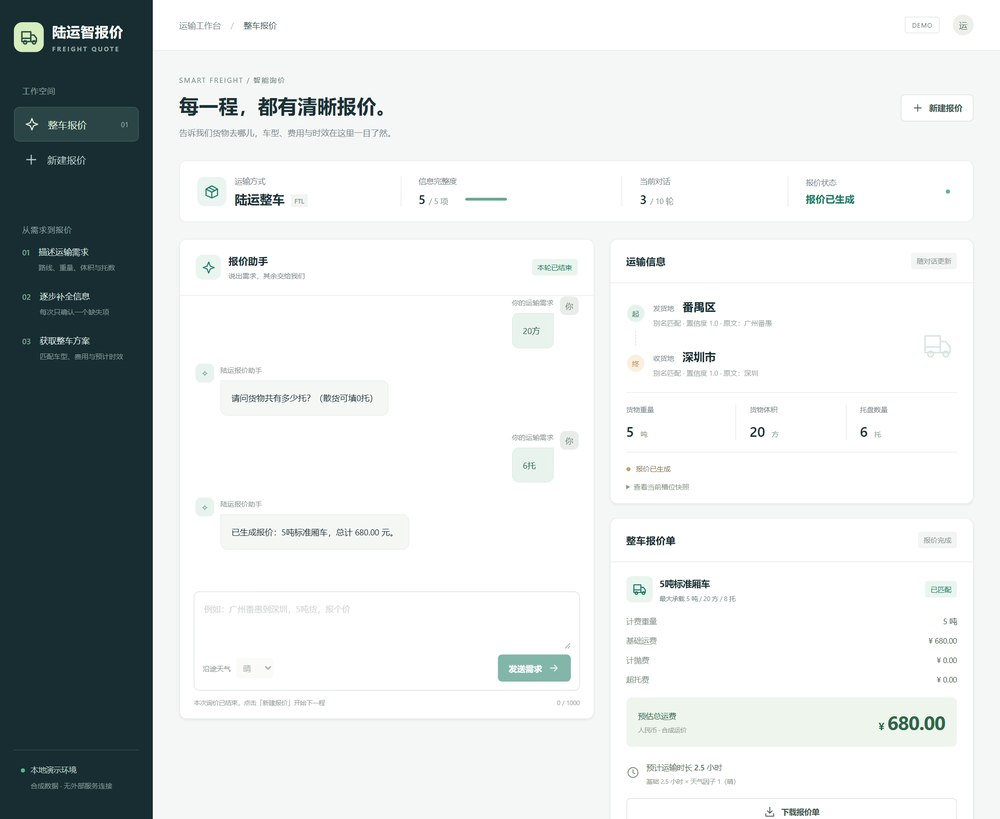
关键在于这套判断是可见的。报价单里每个地点都会标注「匹配方式 + 置信度 + 原文」——截图里写的就是「别名匹配,置信度 1.0,原文:广州番禺」。用户能一眼看出系统有没有听错,而不是等到车派错了才发现。
L2 那条「唯一最优才接受」也是刻意的:多个候选同分时宁可返回失败让人确认,也不擅自选第一个。这和模糊匹配最容易犯的错误正好相反。
费用怎么算的
两套口径分开,不能混:
- 实际重量只负责载重限制(装不下就换车型)
- **体积重(计抛)**只负责费用
车型用三条 SQL 区间匹配,区间都含边界,命中多个时取基础价最低的。费用拆成基础运费、计抛费、超托费三项,报价单上逐项列出,总价是加出来的,不是查表查出来的。
时效同理:基础时长 × 天气因子,界面上写「基础 2.5 小时 + 天气因子 1.0(晴)」,而不是只给一个孤零零的「2.5 小时」。
前端是零依赖的原生实现
web/ 里只有三个文件:HTML、CSS、JS,没有构建步骤、没有框架。加上 web_server.py 用的 Python 标准库 HTTP 服务,整个项目 pip install 完依赖就能跑,不需要 Node.js。
界面把「信息完整度 5/5」「当前对话 3/10 轮」「报价状态」做成顶部进度条,用户随时知道自己离一张报价单还有多远。
工程边界
- 数据全部合成:车型 CSV、运价区间、天气权重都是演示用的,不连真实高德、天气服务或运价库。
- 地址解析是模拟判定,不代表真实行政区校验。
- 会话在内存里,进程退出即丢;SQLite 和 LangGraph 的 MemorySaver 都仅用于演示。
- 报价不按距离加价,遵循 demo 指定的固定公式。
- README 里逐个列出了 8 个模块的「生产替换点」(哪个文件换成鉴权 API、哪个换成持久化 checkpointer、哪个换成真实地理编码),而不是笼统地说「生产环境需要改造」。
项目图集